Overview of hifiasm (ONT)
The existing hifiasm assembly toolkit consists of three approaches: the original hifiasm6, hifiasm (Hi-C)8 and hifiasm (UL)1, each designed for specific purposes. These methods are proposed, respectively, for trio-binning haplotype-resolved assembly using parental data, single-sample haplotype-resolved assembly using Hi-C reads and T2T hybrid assembly. The core component shared by these methods is constructing a high-quality assembly graph through de novo assembly of PacBio HiFi reads. However, owing to the limited length of PacBio HiFi reads, long, repetitive genomic regions often cannot be fully resolved within this core assembly graph.
To address this limitation, longer but less accurate ONT simplex reads, especially ultra-long reads, have been used by existing hybrid T2T assemblers such as hifiasm (UL)1 and Verkko2,10. However, these assemblers do not make full use of ONT ultra-long reads because they cannot perform de novo assembly with them directly. The higher error rate and recurrent sequencing errors of ONT reads pose challenges for distinguishing genomic variations from sequencing errors. As a result, both hifiasm (UL) and Verkko use a two-stage strategy: first, constructing an assembly graph from PacBio HiFi reads with de novo assembly; and second, aligning ONT ultra-long reads to resolve regions that are unresolved by HiFi reads alone. For ONT reads, this alignment-based approach remains inherently limited by inaccuracies and biases introduced in the HiFi-based assembly graph.
Our hifiasm (ONT) approach enhances this core capability by enabling effective de novo assembly of ONT simplex reads, making full use of their longer length. Compared with HiFi-based assembly graphs, ONT-based assembly graphs tend to be more accurate and cleaner, and to resolve more repetitive regions. This improved ONT-based assembly graph substantially improves existing methods in the hifiasm toolkit, such as trio-binning or Hi-C phased assembly. The specific strategies of hifiasm (ONT) for using ONT simplex reads in T2T assembly are detailed below.
Error correction of ONT simplex reads
Error correction generates near-error-free reads by fixing sequencing errors in raw data, which is a crucial step for genome assembly. To correct a given target read R, assembly algorithms need to first collect all related reads originating from the same genomic region. Conventional algorithms assume that any overlapping read belongs to the same genomic region as R if they share high sequence similarity. However, this approach fails to distinguish highly similar repeat copies or haplotypes. As a result, many false-positive reads from other repeats or haplotypes might be incorrectly used to correct R, leading to an overcorrection issue that might collapse repeats and haplotypes in the final assembly.
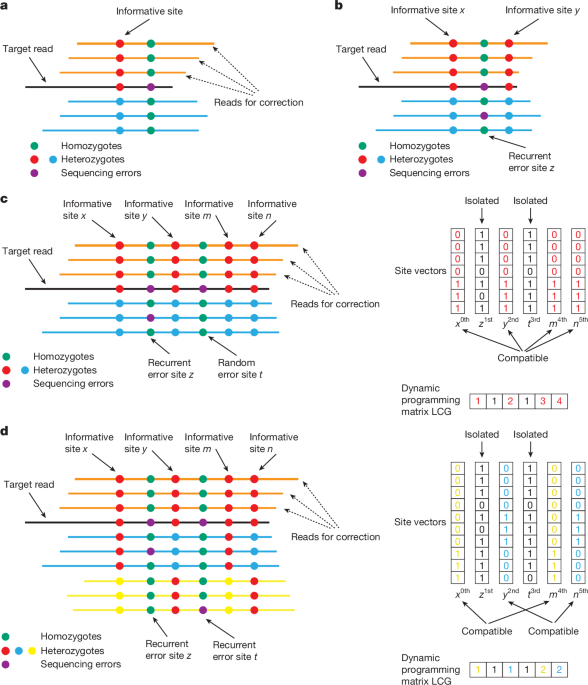
To address this problem when assembling PacBio HiFi reads, hifiasm uses a key assumption that most sequencing errors in PacBio HiFi data occur randomly and typically appear in only a single read. Figure 1a shows an example. When correcting the target read R, hifiasm identifies mismatches through pairwise alignments between R and all overlapping reads. Mismatches that are supported by multiple overlaps are considered as informative sites representing true genomic variants, whereas those that appear in only one read are treated as sequencing errors and ignored. This strategy is essentially similar to widely used variant-calling methods. Subsequently, only overlapping reads showing no differences at these informative sites compared to R are used for correction.
However, this existing hifiasm error-correction strategy is unsuitable for ONT simplex reads (Fig. 1b). Although the overall sequencing error rate of ONT simplex reads is not significantly higher than that of PacBio HiFi reads, ONT simplex reads exhibit a higher frequency of recurrent, non-random errors. Therefore, the current hifiasm method would mistakenly identify these recurrent errors as informative sites. For a target simplex read R, overlapping reads originating from the same genomic region would thus be incorrectly discarded if they differed from R at these recurrent error sites. As a result, most ONT simplex reads would remain uncorrected, and could not be used for de novo genome assembly.
In hifiasm (ONT), we introduce an approach that makes use of the long-range phasing information of ONT reads to improve error correction. The basic idea is that true informative sites representing real genomic variants usually appear together and are mutually compatible with other informative sites. In practice, hifiasm (ONT) clusters potential informative sites on the basis of their compatibility. As shown in Fig. 1c, given a target ONT simplex read awaiting correction, overlapping reads at a potential informative site (x, y, m, n, z or t) can be classified into two phases: phase 0 (matching the target read) and phase 1 (differing from the target read). For two sites, if both consistently classify overlapping reads into identical phases, they are considered compatible and grouped together. True variants are expected to be compatible with multiple other real variant sites. By contrast, isolated sites that lack compatibility with others (such as z and t) have a higher likelihood of representing sequencing errors. This method is conceptually similar to using haplotype phasing to improve the accuracy of variant calling. To further enhance reliability, hifiasm (ONT) adopts the following criteria: (i) an isolated site is considered informative only if it is supported by a sufficiently high number of reads; and (ii) any grouped site that is supported by more than one read is regarded as an informative site, because such sites are inherently more reliable.
In practice, it is necessary to develop an efficient algorithm for grouping potential informative sites, because this operation must be performed for each read during error correction. To achieve this, we propose a dynamic programming method designed to identify the largest compatible group for each site. Specifically, let R be the target read awaiting correction, and S be the list of N potential informative sites within R, sorted by their positions. Here, S[i] denotes the i-th site in the list, and S[ik] represents the phase assignment of the k-th read at site S[i]. The value of S[i][k] can take one of the following states:
$$S[i][k]\in \{0,1,* \},$$
where 0 and 1 indicate that the k-th read is assigned to phase 0 or phase 1, respectively, and * indicates that the k-th read does not cover site S[i].
The dynamic programming method is outlined as follows:
1. Subproblem: Define LCG[i] as the size of the largest compatible group in S that ends at index i and is compatible with S[i]. The objective is to calculate LCG[0] to LCG[N-1] for all sites and identify those with values greater than 1, indicating a compatible group rather than an isolated site.
2. Recurrence relation: The recurrence relation is expressed as LCG(i) = max{LCG(j) + 1 : j < i, S[j] ↔ S[i]}, where S[j] ↔ S[i] signifies compatibility between S[j] and S[i] based on certain conditions. 3. Traceback for grouping sites: The algorithm traces back through compatible sites to group those with LCG[i] > 1, starting from the highest value and proceeding downward.
The time and space complexity of this method are O(n^2) and O(n), respectively, making it efficient for error correction in de novo assembly. It is advantageous for handling polyploid genomes and highly similar repeats with more than two copies. Additionally, the method filters out low-quality base pairs, including potential homopolymer sequencing errors and strand bias, to improve error correction accuracy. Трансформация на входния HTML в един дълбок, информативен и SEO-приятелски статия.
Насочеността на веригата е честа грешка при последователностите на ONT четене.
Нисък резултат за качество на база. Освен последователностните данни, hifiasm (ONT) също зарежда резултати за качество на база в паметта. Всяка базова двойка с резултат за качество по-нисък от 10 се счита за потенциална грешка при последователността и се изключва от изчисляването на информативни места.
Едно потенциално предизвикателство за hifiasm (ONT) възниква, когато грешките при последователността се случват точно на позицията на истински вариант, правейки този вариант несъвместим с другите. Въпреки това в практиката такива случаи са рядкост. Дори ако истинският вариант в едно четене е засегнат от грешки при последователността, други близки варианти, които остават непокътнати, все още могат да бъдат точно открити, позволявайки на hifiasm (ONT) ефективно да раздели хаплотипите и да разреши повтарящите се копия.
Подобрени стратегии за T2T сглобяване
С подхода за коригиране на грешки в hifiasm (ONT) повечето грешки при последователността във входните ONT прости четения могат да бъдат коригирани ефективно. Тези почти безгрешни четения се използват след това със съществуващите стратегии за сглобяване в hifiasm, за да се изгради висококачествен сборен граф. За хаплоидни геноми се прилага стратегия за почистване на графика, за да се произведат линейни резултати за сглобяване. За диплоидни геноми се изискват допълнителни данни – като родителски или Hi-C четения – за генериране на хаплотип-разрешени сборни с помощта на съществуващите трио-бинове или Hi-C фазове в hifiasm.
За да се подобри T2T сглобяването, разработихме стратегия за запазване на теломерни последователности в крайния сбор. Общ проблем в hifiasm е, че въпреки че може да реконструира цели хромозоми, все още може да пропусне теломерни последователности на краищата на хромозомите. Това се случва, защото в сборния граф – особено за диплоидни геноми – теломерните краища често се появяват като върхове. При почистването на графа hifiasm обикновено отхвърля тези върхове, защото повечето от тях са причинени от грешки при сглобяването. В резултат на това теломерните последователности може случайно да бъдат премахнати от крайния сбор. За да се справим с това, подобрената стратегия за T2T сглобяване в hifiasm (ONT) първо проверява дали някакви четения съдържат теломерни последователности преди сглобяването. Ако се открият такива четения, hifiasm запазва съответните върхове на графа по време на почистването на графа. Този подход помага да се запазят повече теломерни краища и дава повече T2T контиги и скелдове.
Разработихме също двойно-скелдов подход за сглобяване на повече хромозоми от теломер до теломер на ниво скелд. Целта е да се сглобят безпропускови контиги в по-дълги, прекъснати скелдове, като се използва информация от двете хаплотипа. Основната идея е, че за една сглобка в хаплотип 1, двойният скелдов подход изучава съответните хомологни региони в хаплотип 2. Ако регионът в хаплотип 2 е напълно сглобен без пропуски, методът за двойно скелдов запълва пропуска в хаплотип 1 с неопределени нуклеотиди (Ns), използвайки оценената дължина, извлечена от пълната последователност в хаплотип 2. По същество, този подход извършва сглобяване с ръководство от справочник за всеки хаплотип, използвайки другия хаплотип като справка.
Четенето и базово предизвикване от ONT
Стандартните прости четения за ONT за пробите GIAB HG001-HG007 бяха депозирани в официалния репозитори на отворени данни на ONT (s3://ont-open-data/giab_2025.01/). Клетъчните линии за тези проби бяха получени от Човешкия генетичен клетъчен репозиториум в Института за медицински изследвания Кориел и бяха отглеждани според препоръчителните протоколи на доставчика. Високомолекулярната ДНК беше изолирана с помощта на кита за екстракция на клетъчния ДНК на QIAGEN Puregene, след което последва библиотечната подготовка с кита SQK-LSK114 според протоколите на ONT, а четенето беше извършено на PromethION поточни клетки с използване на P48 инструменти. Предизвикването на базата беше извършено с помощта на Dorado v.0.7.2 с моделите HAC v.5.0.0 и SUP v.5.0.0. За HG001, HG003, HG004, HG005, HG006 и HG007 бяха предизвикани четения от две поточни клетки и бяха използвани за сглобяването. За HG002 беше използвана само информация от една поточна клетка, защото една поточна клетка беше достатъчна, за да произведе ONT прости четения на приблизително 50-кратно покритие. Освен това пре-базовото предизвикване на съществуващите четения на D. rerio (риба зебра) беше направено с помощта на Dorado v.0.8.3 с модела SUP v.5.0.0, за да се подобри базовата точност на четенето на ниво.
Доклад за резюме
Допълнителна информация за дизайна на изследването е достъпна в Обобщението за докладване на Nature Portfolio, свързано с тази статия.