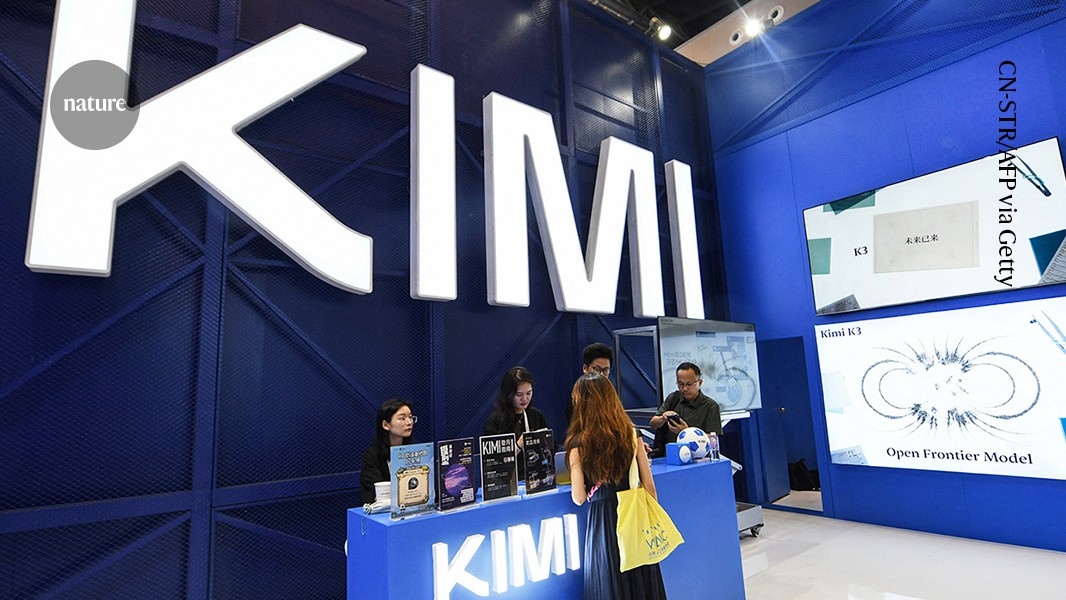
Най-новият голям езиков модел (LLM), създаден в Китай, впечатлява учените със своя размер и възможности. Миналата седмица базираният в Пекин Moonshot AI представи „Kimi K3“, мощен LLM с разсъждения, който може да обработва големи текстови участъци. Собствените тестове на компанията установиха, че K3 може да съвпадне или да надмине съперничещите американски модели при задачи като кодиране и манипулиране на електронни таблици.
Откакто DeepSeek китайски модел с изкуствен интелект не е предизвиквал толкова шум. „Това е повратна точка“, казва Джоел Пиърсън, когнитивен невролог в UNSW Сидни в Австралия, който изучава как ИИ влияе върху живота на хората. „Хората го наричат „момент на Спутник“, добавя той.
Три дни след пускането на модела, Moonshot AI каза, че е спрял новите регистрации за K3, тъй като търсенето е тласнало системата й близо до границите на нейния капацитет за обработка.
Пускането на модела на 16 юли беше точно преди Световната конференция за изкуствен интелект през 2026 г. в Шанхай. Конференцията започна с китайския президент Си Дзинпин, който обяви официалното начало на глобален съюз за създаване на регулация, която гарантира, че ИИ е безопасен и е от полза за хората. „Според Китай всички страни трябва да възприемат ориентиран към хората подход и да развиват ИИ за положителното и за добро“, каза Си на конференцията, добавяйки, че ИИ трябва да бъде двигател за „споделен просперитет и обща сигурност“.
Времето за пускане на Kimi K3 е важно, казва Мехвиш Насим, изследовател на AI в Университета на Западна Австралия в Пърт. Моделът беше пуснат само седмици след Claude Fable 5 от американската компания Anthropic и дни след като OpenAI пусна най-новия си модел GPT-5.6. „Китай сигнализира за своята амбиция не само да изгради гранични системи за изкуствен интелект, но и да помогне за оформянето на международната екосистема на изкуствения интелект и нейното управление“, казва тя.
Най-големият модел с отворено тегло
K3 е с отворено тегло, подобно на предшественика си Kimi K2 и моделите DeepSeek, които са разработени от базирана в Хангжу фирма със същото име, което означава, че основните му компоненти са публично достъпни и могат да бъдат изтеглени и модифицирани от изследователи безплатно, докато информацията за обучението на модела е лична. Той може също да бъде достъпен с помощта на „интерфейс за програмиране на приложения“, който позволява на софтуера да комуникира на по-ниска цена от патентованите LLM, като тези, притежавани от OpenAI, Google и Anthropic. Тези LLM са затворени, което означава, че не могат да бъдат изтеглени и модифицирани.
Moonshot казва, че теглата или параметрите ще бъдат публикувани на 27 юли. Рахул Шоме, изследовател по роботика и изкуствен интелект в Австралийския национален университет в Канбера, казва, че е имало натиск от потребители, разработчици и изследователи да направят моделите на изкуствен интелект отворени. K3 е особено вълнуващ, защото ще бъде най-големият отворен модел, казва Shome, с 2,8 трилиона параметри и работна памет от един милион жетона (текстовите единици, използвани от AI моделите). Моделът обаче е твърде голям, за да работи на персонални устройства, така че вероятно ще изисква значителни инвестиции от страна на институциите, за да го управлява, добавя той.
Голямата работна памет на K3 означава, че може да запомни съдържанието на хиляди редове код или цяла книга и да намали вероятността от производство на изфабрикувана информация, наречена халюцинация, казва Ниуша Шафиабади, изследовател на изчислителната интелигентност в Австралийския католически университет в Сидни. Shafiabady казва, че ще тества K3 за себе си, като го помоли да обобщи резултатите от изследването.
Затваряне на празнината
Производителността и възможностите на моделите с отворено тегло исторически изостават от тези на патентованите в САЩ. Но разликата изглежда е най-малката, която някога е била, казва Арън Снозуел, изследовател на отчетността на AI в Generative AI Lab на Куинсландския технологичен университет, Бризбейн.
Pearson казва, че китайските отворени модели променят начина, по който инвеститорите и потребителите възприемат стойността на граничните модели на САЩ. Google, Anthropic и OpenAI харчат милиарди долари за обучение на своите модели в сравнение с много по-ниските бюджети на китайските компании. Освен това, потребителите могат да загубят достъп до американските модели, ако правителството реши да наложи ограничения, казва Пиърсън. Миналия месец Anthropic временно деактивира своите най-модерни модели, Fable 5 и Mythos 5, за всички потребители, след като беше наредено от правителството на САЩ да спре достъпа за чуждестранни граждани. Достъпът до Fable 5 беше възстановен този месец, но Mythos 5 е достъпен само за определени американски организации.
Тоби Уолш, компютърен учен в UNSW, казва, че китайските AI компании са успели да изградят гранични AI модели, въпреки че Съединените щати ограничават достъпа на Китай до усъвършенствани AI чипове, позовавайки се на опасения за националната сигурност. „Човек подозира, че необходимостта тук е майката на изобретението“, добавя той.